Ramverk för datadriven personalisering
“Vi måste i större utsträckning basera vår personalisering på data.”
Du har säkert hört det här på ett möte. Kanske har du själv sagt det. Problemet är inte ambitionen. Problemet är att ”datadriven personalisering” betyder allt och ingenting på samma gång.
Menar man att visa produkter utifrån surfhistoriken? Att segmentera e-postlistor efter köpbeteende? Att använda AI för att förutsäga vad kunderna vill ha? Allt ovanstående?
Här är ett praktiskt ramverk för att fundera över saken utan att fastna i fackjargongen.
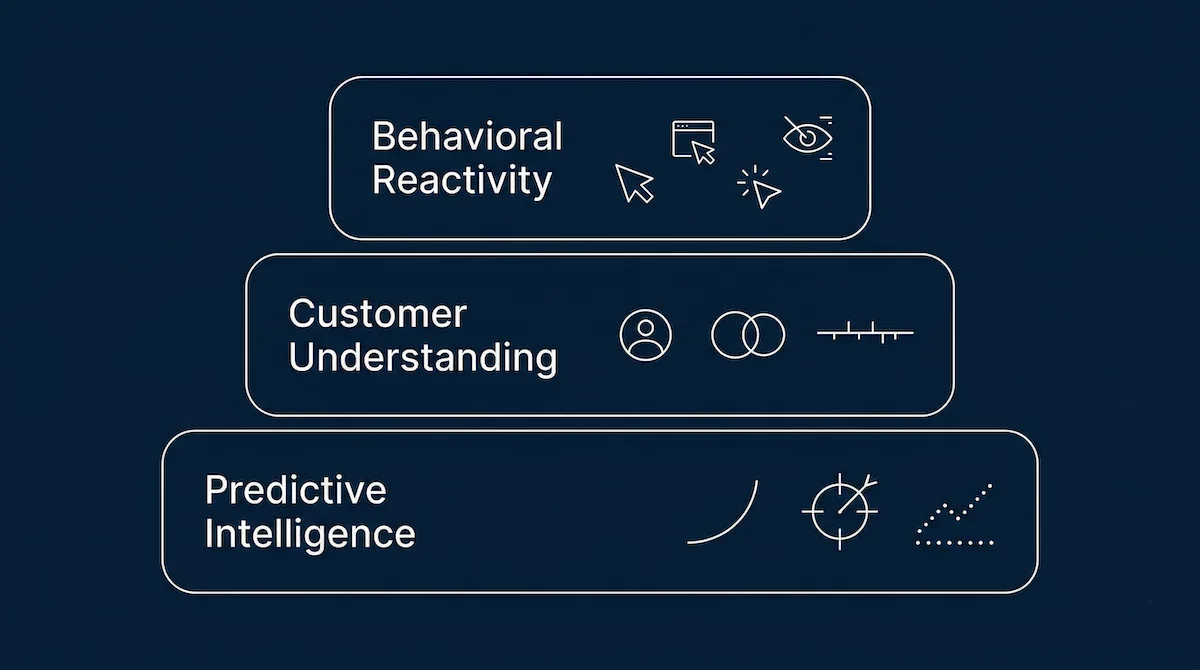
De tre nivåerna av datadriven personalisering
Tänk på personalisering som tre olika lager, där varje lager bygger vidare på det underliggande. Du kan implementera dem stegvis, och det bör de flesta butiker göra.
Nivå 1: Beteendemässig reaktivitet
Det här är grunden. Ditt system reagerar i realtid på vad en kund gör.
En kund tittar på en produkt → visa relaterade produkter. En kund söker efter ”löparskor” → anpassa sökresultaten utifrån kundens tidigare interaktioner. En kund lämnar en varukorg → skicka ett påminnelsemejl med de produkter som lämnats kvar i varukorgen.
Beteendemässig reaktivitet kräver tre saker:
- Händelseuppföljning (registrering av sidvisningar, sökningar, lägg-i-kundvagn-åtgärder och köp i realtid)
- Ett rekommendationslager som kan bearbeta dessa händelser och föreslå relevanta produkter
- Integration av kontaktpunkter (koppling av rekommendationslagret till din webbplats, e-postplattform och sökfunktion)
De flesta moderna plattformar för e-handel erbjuder grundläggande beteendebaserad respons redan från början. Möjligheterna är begränsade, men det är en bra utgångspunkt eftersom implementeringen är hanterbar och avkastningen på investeringen märks omedelbart.
Nivå 2: Förståelse för kunden
Det är här som personaliseringen blir betydligt bättre. Istället för att bara reagera på det senaste klicket bygger systemet upp en varaktig förståelse för varje kund.
Att förstå kunden innebär att man vet att just denna besökare föredrar premiummärken, oftast handlar till sig själv och sin dotter, brukar handla under rea-kampanjer och har en komplett garderob med friluftsutrustning, med undantag för vintertillbehör.
Detta lager kräver:
- Identitet över flera sessioner (sammanlänkning av beteenden mellan besök, enheter och kanaler)
- Preferensmodellering (att dra slutsatser om preferenser utifrån beteendemönster, inte bara utifrån uttryckliga handlingar)
- Segmentanalys (att förstå var varje kund befinner sig i termer av livscykel, värde och intresse)
För att skapa en omfattande förståelse för kunderna krävs det att man bearbetar beteendedata från många olika källor och kopplar samman dem med egenskaper på produktnivå.
Nivå 3: Prediktiv intelligens
Det mest avancerade lagret. Istället för att reagera på vad kunderna har gjort eller försöka förstå vad de gillar, förutsäger systemet vad de kommer att göra härnäst.
Prediktiv intelligens innebär att man förutser att en kund som köpte ett tält förra månaden kommer att behöva sovsäckar och campingköksutrustning inom de närmaste veckorna, och att man visar upp dessa produkter innan kunden söker efter dem.
Detta lager kräver:
- Tillräcklig datamängd (prognoser kräver stora datamängder för att bli korrekta)
- Kunskap om produktens livscykel (förståelse för påfyllningscykler, tidpunkten för kompletterande inköp och säsongsmönster)
- Kollektiv intelligens (att dra lärdom av mönster som gäller många kunder och butiker, inte bara utifrån dina egna data)
De flesta medelstora butiker kan inte nå lager 3 enbart med sina egna data. Det är här Plattformar för Product Intelligence bli värdefullt genom att dra nytta av insikter från samlade beteendemönster inom ett ekosystem av liknande butiker.
Den information du faktiskt behöver
E-handelsteam antar ofta att datadriven personalisering kräver ett datalager, ett team av analytiker och flera månaders förberedelser. Så är det inte.
Här är den minsta datamängd som krävs för att varje lager ska fungera:
För nivå 1 (beteendemässig reaktivitet):
- Händelser för sidvisningar (produkt-ID + tidsstämpel)
- Sökfrågor (söktext + resultat som man klickat på)
- Händelser vid läggning i varukorgen (produkt-ID + antal)
- Köphändelser (order-ID + produkter + belopp)
För nivå 2 (kundförståelse):
- Allt i lager 1, plus:
- Kundens identitet över flera sessioner (e-postadress, konto eller permanent cookie)
- Köphistorik med datum och belopp
- Data om e-postengagemang (öppningar, klick)
För lager 3 (prediktiv intelligens):
- Allt i nivåerna 1–2, plus:
- Produktattributdata (material, modeller, användningsområden, prisklasser)
- Lageruppgifter (lagernivåer, inkommande leveranser)
- Externa signaler (säsongsvariationer, marknadstrender)
Den viktigaste insikten är att lager 1 och 2 utnyttjar data som du med största sannolikhet redan samlar in. Du kopplar förmodligen bara inte ihop den med dina personaliseringspunkter.
Vanliga felorsaker
”Spruta och be”-metoden
Att installera en rekommendationswidget på varje sida med standardinställningar är inte datadriven personalisering. Det är bara pynt. Widgeten visar ”bästsäljare” för alla eftersom den inte matas med beteendedata, eller så har dataanslutningen aldrig konfigurerats korrekt.
Strategin med ”datahamstring”
Att samla in alla möjliga datapunkter utan ett tydligt användningssyfte för personalisering. Resultatet blir terabyte av händelsedata i ett datalager, en månatlig analysrapport som ingen läser och samma generiska shoppingupplevelse som du började med.
Strategin att ”segmentera allt”
Att skapa dussintals kundsegment (högvärdiga vinterkunder som föredrar ekologiska produkter och bor i stadsområden) låter sofistikerat, men resulterar i mycket små målgrupper som inte har tillräcklig statistisk tyngd för att möjliggöra en meningsfull personalisering. Börja med 3–5 breda segment och låt den algoritmiska personaliseringen hantera nyanserna inom varje segment.
”Enkanals”-metoden
Att anpassa webbplatsen men skicka generiska e-postmeddelanden. Eller att anpassa e-postmeddelandena men visa samma startsida för alla. Kunderna upplever ditt varumärke i olika kanaler. Om anpassningen inte följer med dem upplevs det som inkonsekvent.
Bygga upp din stack
En praktisk, datadriven personaliseringslösning för en medelstor e-handelsbutik ser ut så här:
-
Lager för händelseinsamling. Ett JavaScript-snippet eller en tagghanterarkonfiguration som registrerar beteendehändelser och skickar dem till din personaliseringsplattform. Detta är ett absolut krav.
-
Personaliseringsmotor. Systemet som bearbetar beteendedata och produktdata för att generera rekommendationer och personanpassade upplevelser. Detta utgör kärnan i teknikstacken.
-
Touchpoint-anslutningar. Integrationer som ger personliga upplevelser på din webbplats (sökning, rekommendationer), i din e-postplattform och i andra kundinriktade kanaler.
-
Produktdataflöde. Ett strukturerat flöde av din produktkatalog med attribut, priser och tillgänglighet. Detta är det råmaterial som personaliseringsmotorn arbetar med.
Den goda nyheten är att integrerade plattformar som Hello Retail slår samman punkterna 2–4, vilket innebär att du inte behöver bygga och underhålla separata integrationer för varje lager.
Hur detta hänger ihop med ”Hello Retail”
Hello Retails strategi för datadriven personalisering följer direkt den tredelade modellen. Product Intelligence-motorn hanterar kundinsikter och prediktiv analys. Produkterna för sökning och rekommendationer erbjuder personaliserade upplevelser i alla kontaktpunkter. Och Product Agents utökar personaliseringen till inkorgen.
Det som gör denna metod praktiskt användbar för medelstora butiker är lagret med kollektiv intelligens: beteendemönster som samlats in via Hello Retail-nätverket förbättrar kvaliteten på personaliseringen utan att det krävs omfattande datamängder från enskilda butiker.
Viktiga slutsatser
- Datadriven personalisering består av tre nivåer: Beteendereaktivitet, kundförståelse och prediktiv intelligens. Implementera dem i tur och ordning
- Du har redan större delen av den information du behöver för nivå 1 och 2; det som saknas är att koppla ihop den med personaliseringspunkterna
- Undvik vanliga felkällor: Dekorativa widgetar, att samla in data utan att vidta åtgärder, överdriven segmentering och personalisering via en enda kanal
- Kollektiv intelligens löser problemet med datamängden för medelstora butiker, vilket gör Layer 3 tillgängligt även utan trafik i företagsstorlek
Keep reading
Hur man mäter avkastningen på investeringar (ROI) i personalisering inom e-handeln (med konkreta siffror)
McKinsey: De bästa aktörerna inom personalisering ökar sin omsättning med 40 % tack vare detta. 26 % av marknadsförarna får tillbaka 3–5 dollar per investerad dollar. Ramverket för A/B-testning, de tre nyckeltalen som spelar roll och vad kontrollgrupper egentligen avslöjar.
Personalisering kontra anpassning
Personalisering och anpassning låter liknande, men fungerar på olika sätt. Här förklarar vi när du bör använda respektive metod i din strategi för e-handel.