Waarom productgegevens de meest onderbenutte troef in de detailhandel zijn
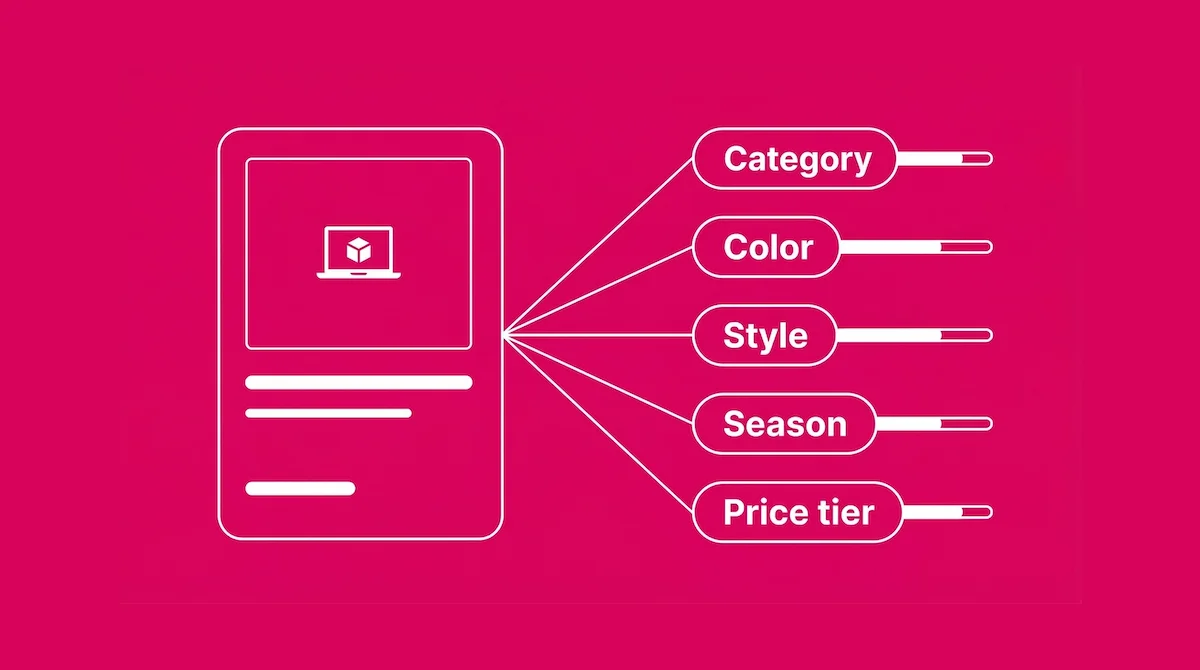
Je weet de kleur, maat, prijs en categorie van elk product in je catalogus. Waarschijnlijk heb je ook beschrijvingen, afbeeldingen, het gewicht en informatie over het materiaal.
Vraag jezelf nu eens af: Wat doe je eigenlijk met al die informatie, behalve het op een productpagina zetten?
Voor de meeste retailers is het antwoord: Verrassend weinig. Productgegevens staan in een PIM- of ERP-systeem, worden naar de website gestuurd, en daar houdt het dan op. De meest uitgebreide dataset binnen je bedrijf wordt behandeld als iets wat je gewoon moet publiceren, in plaats van als een strategisch bezit.
Het verschil tussen het hebben van gegevens en het gebruiken ervan
Er is een fundamenteel verschil tussen het opslaan van productgegevens en het begrijpen ervan.
Gegevens opslaan betekent dat je weet dat SKU-4829 een „blauw katoenen T-shirt, maat M, $29,99” is. Het begrijpen ervan betekent dat je weet dat dit product een specifiek klantsegment aanspreekt, het beste presteert wanneer het naast slim-fit jeans wordt getoond, in het voorjaar hogere conversiepercentages haalt en concurreert met drie vergelijkbare producten in je catalogus die elkaars omzet kannibaliseren.
Bij de meeste ecommerce-platforms krijg je het eerste deel gratis. Het tweede deel, de daadwerkelijke productinformatie, vereist dat productkenmerken op grote schaal aan gedragsgegevens worden gekoppeld.
Hier ligt de kans. Winkeliers die productgegevens zien als een bron van informatie, nemen betere beslissingen over het assortiment, aanbevelingen, prijzen en voorraad. Winkeliers die het zien als louter een catalogusinfrastructuur, laten geld liggen.
Hoe productinformatie er eigenlijk uitziet
Productrelaties die verder gaan dan categorieën
Volgens je categorietaxonomie vallen ‘T-shirts’ en ‘poloshirts’ allebei onder ‘Heren-tops’. Dat is handig voor de navigatie. Maar voor personalisatie is het bijna nutteloos.
Uit productinformatie blijkt dat een specifiek blauw katoenen T-shirt heel goed past bij een bepaalde grijze chino en een marineblauwe canvasriem, niet omdat een merchandiser dat zo heeft besloten, maar omdat aankoopgegevens van duizenden transacties dit patroon laten zien. Deze verbanden bestaan op het niveau van het individuele product en veranderen in de loop van de tijd.
Inzicht in deze verbanden vormt de basis voor slimme productaanbevelingen. Het verschil tussen suggesties onder ‘Dit vind je misschien ook leuk’ die willekeurig aanvoelen en suggesties die bijna helderziend lijken, komt neer op de kwaliteit van de gegevens over productrelaties.
Productgroepering
Niet alle producten binnen een categorie zijn onderling uitwisselbaar. Onder de noemer ‘hardloopschoenen’ vind je trailschoenen, wegschoenen, snelheidsschoenen en stabiliteitsschoenen. Binnen elk van die categorieën zijn er budget-, middenklasse- en premium-segmenten. En binnen elk segment zijn er stijlverschillen die verschillende klantsegmenten aanspreken.
Bij productclustering worden kenmerken en gedragssignalen gebruikt om producten te groeperen op basis van hoe klanten ze daadwerkelijk zien, niet op basis van hoe je merchandisingteam ze indeelt. Dit verschil is belangrijk, want klanten winkelen niet op categorie. Ze winkelen op basis van behoefte, gelegenheid en voorkeur.
Als je systeem productgroepen herkent, kan het slimmere vervangingsvoorstellen doen (“dit product is niet op voorraad, maar hier is het product dat er het meest op lijkt”), betere cross-sell-suggesties geven en meer genuanceerde zoekresultaten bieden.
De gevolgen voor het bedrijf
Als productgegevens veranderen in productinformatie, versterken de effecten elkaar over alle kanalen heen.
Zoeken wordt slimmer. In plaats van zoekwoorden te koppelen aan producttitels, kan de zoekfunctie nu synoniemen, gerelateerde begrippen en de semantische betekenis begrijpen. Een klant die zoekt op ‘warme winterjas’ krijgt resultaten die zijn gerangschikt op basis van daadwerkelijke warmtecijfers en klantrecensies waarin warmte wordt genoemd, in plaats van producten met ‘warm’ in de titel.
Aanbevelingen worden relevanter. In plaats van regels als ‘vaak samen gekocht’ die gebaseerd zijn op het aantal gezamenlijke aankopen, weerspiegelen aanbevelingen nu echte verbanden tussen producten. Het verschil is subtiel in de beschrijving, maar heeft een grote invloed op de conversiepercentages.
E-mail wordt persoonlijk. In geautomatiseerde e-mails kun je producten aanbevelen die echt een aanvulling vormen op wat de klant net heeft gekocht, op basis van kennis op productniveau in plaats van alleen de categorie waar het product onder valt.
Merchandising wordt steeds meer datagestuurd. Productplaatsing, het samenstellen van de startpagina en het kiezen van promoties kunnen allemaal worden gebaseerd op gegevens over de prestaties van producten, in plaats van op een onderbuikgevoel.
Begin met wat je hebt
Je hoeft niet je hele data-infrastructuur opnieuw op te bouwen om meer waarde uit productgegevens te halen. Begin met deze stappen:
-
Controleer je productkenmerken. Hoe volledig en consistent zijn je gegevens? Ontbrekende kenmerken beperken wat een analysesysteem allemaal kan doen. Concentreer je op de kenmerken die voor jouw categorie het belangrijkst zijn: Materialen voor mode, specificaties voor elektronica, ingrediënten voor voedingsmiddelen en schoonheidsproducten.
-
Koppel productgegevens aan gedragsgegevens. Welke producten worden bekeken maar niet gekocht? Welke producten worden aan het winkelmandje toegevoegd maar uiteindelijk niet afgerekend? Welke producten zorgen voor herhalingsaankopen? Deze gedragssignalen veranderen statische productgegevens in dynamische inzichten.
-
Let op kannibalisatie. Als je vergelijkbare producten hebt die strijden om dezelfde zoekopdrachten en aanbevelingsplaatsen, verdeel je je eigen verkeer. Door producten te clusteren kun je kannibalisatie opsporen en betere beslissingen nemen over je assortiment.
-
Houd de indicatoren van de productlevenscyclus bij. Volg hoe individuele producten hun levenscyclus doorlopen: De introductiefase, groei, volwassenheid en achteruitgang. Dit is van invloed op alles, van de prijsstrategie tot het moment waarop je vervangende producten op de markt brengt.
Hoe dit verband houdt met Hello Retail
Het Product Intelligence-platform van Hello Retail is ontworpen vanuit het idee dat productgegevens een levend bezit moeten zijn, en geen statische catalogus. Het koppelt productkenmerken aan gedragssignalen uit het hele Hello Retail-netwerk om zo een gedetailleerd inzicht op productniveau op te bouwen.
Deze informatie wordt in elk contactmoment verwerkt (zoeken, aanbevelingen en e-mail), zodat dezelfde productkennis de basis vormt voor de hele klantervaring. Voor retailers betekent dit dat één investering in productgegevens een cumulatieve meerwaarde oplevert in alle kanalen.
Belangrijkste punten
- De meeste winkeliers slaan productgegevens op, maar gebruiken die niet om er inzichten uit te halen. De kloof tussen het hebben van gegevens en het begrijpen ervan biedt een enorme kans om je te onderscheiden van de concurrentie
- Productrelaties op het niveau van de individuele SKU, en niet op categorieniveau, zorgen voor de meest effectieve personalisatie
- Uit productclustering blijkt hoe klanten je catalogus daadwerkelijk zien, en dat is anders dan hoe je team hem heeft ingedeeld
- De waarde van productinformatie komt tot uiting in zoekresultaten, aanbevelingen, e-mail en merchandising. Het loont in elk kanaal, niet slechts in één
Keep reading
De vijf stappen die het verschil maken tussen winnaars en verliezers in de ecommerce
Twintig jaar groei, vijf concrete stappen. Het verschil tussen winkels die het redden en winkels die het goed doen, zit zelden in de strategie. Het zit ’m in de discipline.
Waarom slimme winkeliers op zoek gaan naar gegevens aan de rand van de data
De meeste webecommercewinkels richten zich op de voor de hand liggende dingen. De echte kansen liggen juist in de marge, waar de ruis van één winkel het signaal van het netwerk wordt.